말하는 모델과 그리는 모델 — Nexus Talk와 LiloImage
캐릭터는 말을 건네고, 눈에 보여야 합니다. 턴 단위 대화 리듬을 학습한 27B LLM Nexus Talk, 장면이 바뀌어도 같은 얼굴을 그리는 애니메이션 이미지 모델 LiloImage. 응답은 사람의 대화 턴 길이로 줄이되 말투는 그대로 지키고, 외부 API 없이 GPU 한 장에서 장면당 약 40초 만에 같은 캐릭터를 다시 그려 냅니다. 범용 모델이 평균을 좇는 자리에서, 두 모델은 한 캐릭터의 일관성을 끝까지 지킵니다.
작성 — ONE AI Labs
캐릭터 하나가 살아 있다고 느껴지려면 두 가지가 필요합니다. 말을 건넬 수 있어야 하고, 눈에 보여야 합니다. ONE AI Labs가 모델을 직접 만드는 이유도 여기에 있습니다. 대화를 맡는 27B 언어 모델 Nexus Talk, 장면을 그리는 애니메이션 이미지 모델 LiloImage. 이 글에서는 두 모델이 각각 무엇을 바꿨는지, 그리고 왜 범용 모델을 그대로 쓰지 않았는지를 설명합니다.
두 모델이 풀려는 문제는 결이 같습니다. 범용 모델은 평균적으로 잘하도록 만들어져 있습니다. 대화에서는 길고 친절한 답을, 이미지에서는 그럴듯한 한 장을 줍니다. 캐릭터 서비스에 필요한 것은 그 반대입니다 — 짧게 말하고 멈추는 리듬, 컷이 바뀌어도 같은 얼굴. 평균이 아니라 일관성입니다.
Nexus Talk — 답하는 모델이 아니라, 말을 건네는 모델
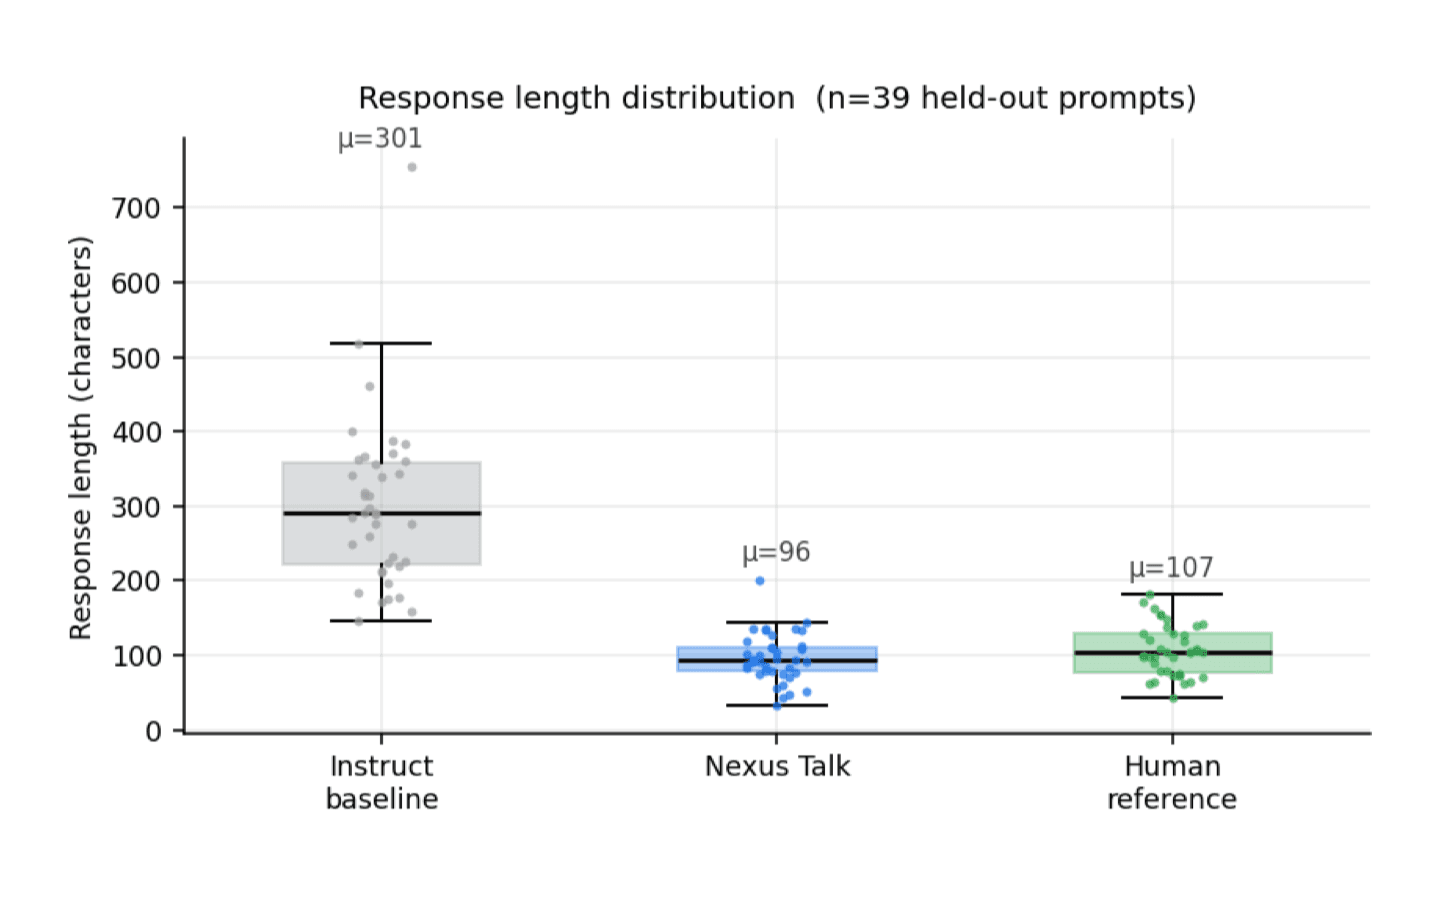
Instruct 모델은 질문에 답하도록 학습됩니다. 그래서 캐릭터 대화에 넣으면 한 턴에 몇 문단을 쏟아내고, 매번 질문으로 끝내며, 상대가 끼어들 틈을 주지 않습니다. 사람끼리의 대화는 다릅니다. 한 가지를 말하고, 멈추고, 발언권을 넘깁니다. Nexus Talk는 한국어 멀티턴 캐릭터 대화로 바로 이 턴 단위 행동 — 얼마나 말하고, 언제 멈추고, 언제 되묻는지 — 을 학습한 27B 모델입니다.
행동은 바꾸고, 목소리는 그대로
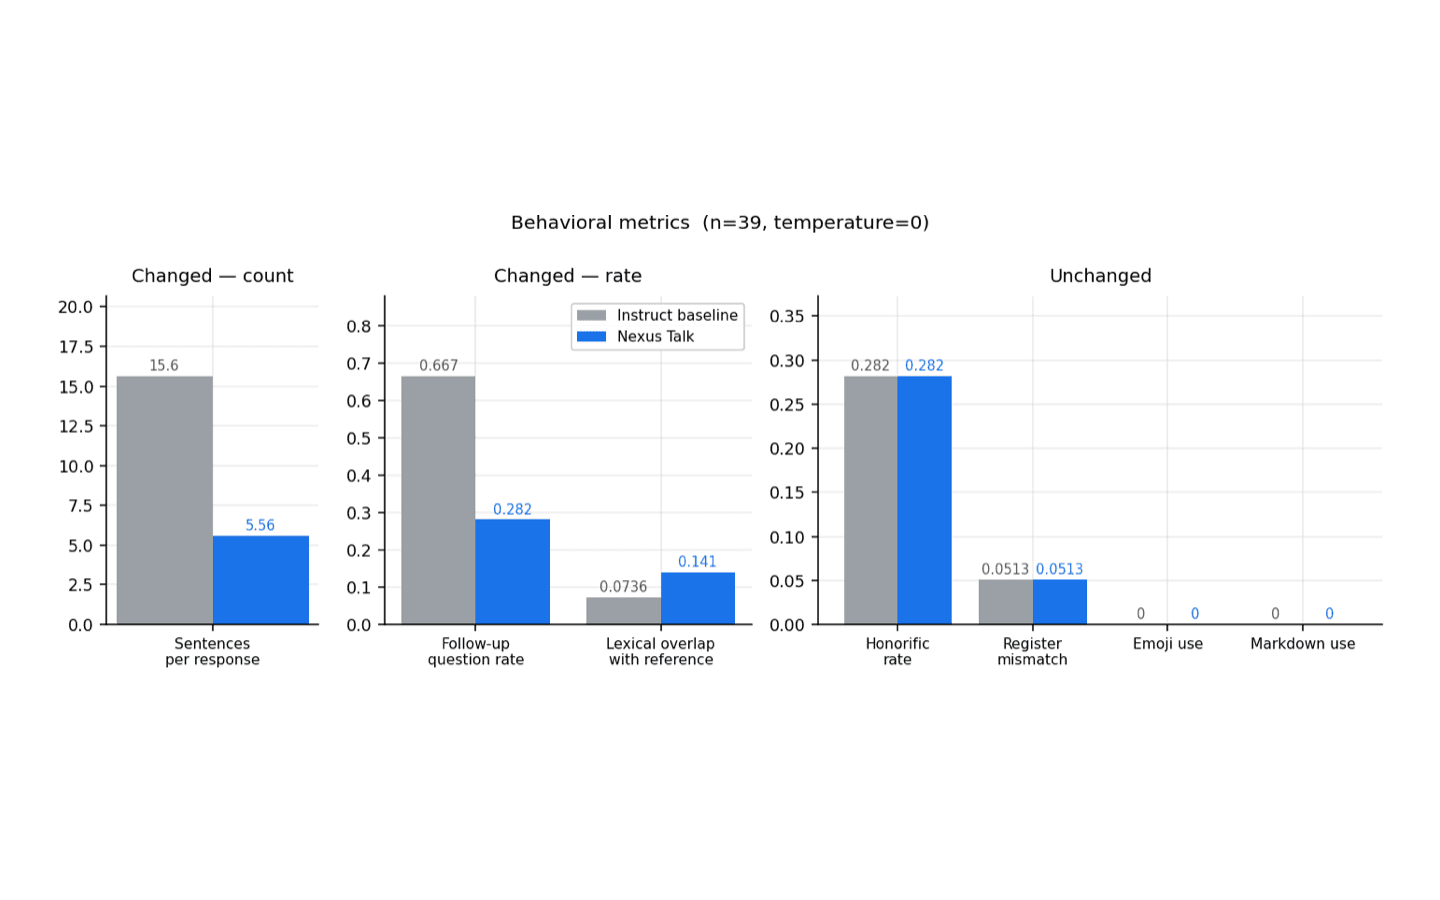
미세조정에서 가장 경계한 것은 말투까지 바뀌는 것이었습니다. 캐릭터의 반말·존댓말, 성격, 톤은 서비스가 시스템 프롬프트로 정해야 하는 영역입니다. 결과적으로 응답당 문장 수(15.6 → 5.56)와 되묻기 비율은 크게 바뀌었지만, 존댓말 비율(0.282)·말투 불일치(0.0513)·이모지·마크다운 사용은 기준 모델과 소수점 넷째 자리까지 같습니다. 바뀐 것은 대화의 리듬이고, 캐릭터의 목소리는 그대로입니다.
무엇을 얼마나 고쳤나 — LoRA 가중치 변화
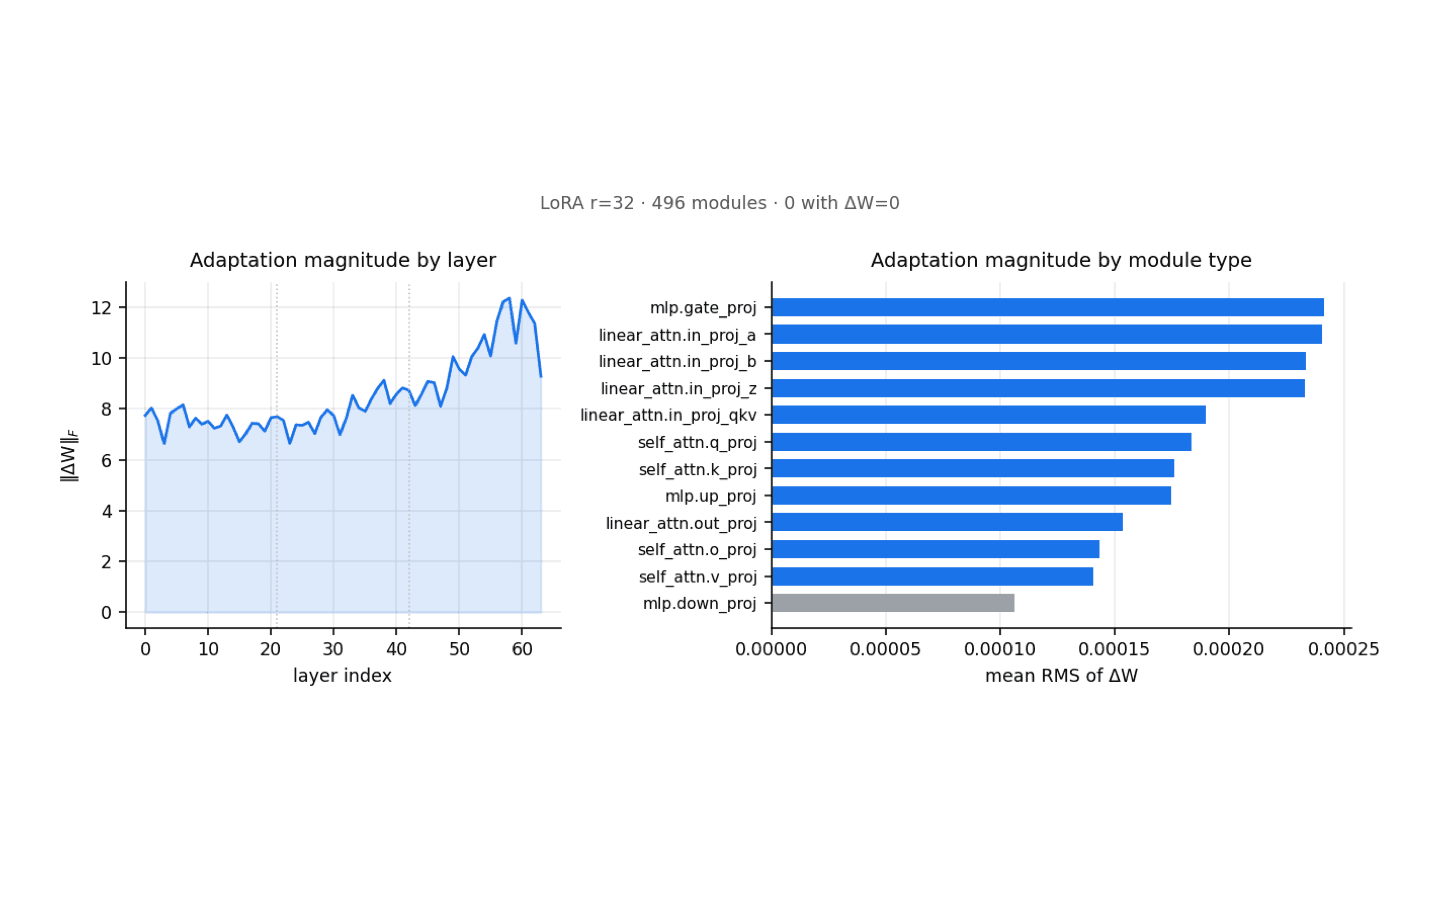
학습은 rank 32의 LoRA로 진행했고, 적용한 496개 모듈 모두에서 가중치가 실제로 움직였습니다. 변화량은 뒤쪽 레이어로 갈수록 커집니다. 앞쪽 레이어가 언어 이해를 담당하고 뒤쪽 레이어가 출력 형태를 결정한다는 일반적인 해석과 맞아떨어집니다 — 무엇을 알고 있는지보다 어떻게 말하는지를 고쳤다는 뜻입니다. 모듈별로는 MLP 게이트와 linear attention 입력 투영이 가장 많이 바뀌었습니다.
베이스는 linear attention과 full attention을 섞은 하이브리드 어텐션 디코더이고, 권장 컨텍스트는 8,192 토큰입니다. v0.2에서는 학습 데이터의 영문 캐릭터 카드를 한국어로 옮기고 한자·엠대시를 걷어내, 28턴 장기 대화 테스트에서 중복 문장부호가 0건이 됐습니다. LoRA를 병합한 bfloat16 가중치는 Apache-2.0으로 Hugging Face에 공개되어 있습니다.
vllm serve nexus-cross/nexus-talk-27b-ko-v0.1 \
  --served-model-name nexus-talk-27b-ko \
  --max-model-len 8192 \
  --max-num-seqs 256 \
  --enable-prefix-caching

# 요청 본문에는 반드시 thinking을 끈다 — 켜면 한국어 응답이 비어 나온다
"chat_template_kwargs": { "enable_thinking": false }LiloImage — 한 캐릭터를, 어느 각도에서든 같은 얼굴로
이미지 모델에게 같은 캐릭터를 열 번 그려 달라고 하면, 열 명의 비슷한 사람이 나옵니다. 머리색이 조금씩 다르고, 옷의 디테일이 바뀌고, 앵글이 바뀌면 얼굴형까지 달라집니다. 한 장짜리 일러스트라면 문제없지만, 같은 캐릭터가 수십 개의 장면에 등장하는 서비스에서는 치명적입니다. LiloImage는 ONE AI Labs Hub의 캐릭터 장면을 그리는 사내 전용 애니메이션 이미지 모델이고, 목표는 하나입니다 — 장면이 바뀌어도 같은 캐릭터.
한국어 장면 한 줄에서 1664×2216 세로 컷까지, 다섯 단계
캐릭터마다 바이블(외형·복장 설정 문서)과 레퍼런스 시트가 있습니다. 작가가 한국어로 장면 한 줄을 적으면 다음 다섯 단계가 이어집니다.
- 레퍼런스 정리 — 비전-언어 모델이 레퍼런스 시트에서 정면 전신 한 컷만 잘라낸다.
- 프롬프트 재작성 — 같은 모델이 한국어 장면을 90~150단어 영문 프롬프트로 다시 쓴다. 카메라 문장만은 모델이 아니라 고정 표에서 붙인다.
- 구도 — 약 1MP 해상도로 구도를 먼저 그린다. 1인칭·높이·뒷모습 같은 장면 유형별 카메라 어댑터가 앵글을 고정한다.
- Identity 이식 — 레퍼런스 두 장으로 얼굴·머리색·복장을 옮겨 심는다.
- 마감 — 확산 과정이 없는 애니메이션 전용 업스케일러로 1664×2216까지 키운다.
모델이 추측하지 못하게 한다
일관성을 무너뜨리는 가장 큰 원인은 모델의 추측입니다. 그래서 LiloImage는 추측할 여지를 하나씩 없앴습니다. 머리색과 복장은 이미지에서 읽지 않고 캐릭터 바이블의 외형 문장을 그대로 씁니다. 카메라 앵글은 모델이 문장을 지어내는 대신 하이앵글·로우앵글·탑다운·POV를 고정 표에서 정확히 지정합니다. 장면마다 첫 구도를 정하는 연출 지시 28종을 넣기 전과 후를 같은 기준으로 평가하자 점수가 모두 올랐습니다.
실험에서 얻은 두 가지 규칙
- 레퍼런스는 한 컷으로 — 여러 포즈가 담긴 시트를 그대로 넣었더니 12장 중 12장이 시트의 배치까지 베꼈다. 그래서 정면 전신 한 컷을 먼저 잘라내 그 컷만 쓴다.
- 구도는 작게, 마감은 크게 — Identity 이식은 2MP를 넘기면 인물이 복제되거나 번진다. 그래서 약 1MP에서 구도와 인물을 확정하고, 디테일을 새로 지어내지 않는 업스케일러로 해상도만 키운다.
이렇게 그린 장면은 5초 영상의 첫 프레임이 됩니다. 시작 프레임의 얼굴과 복장이 정확하니 영상 끝까지 캐릭터가 흔들리지 않습니다. 모든 처리가 사내 GPU 안에서 끝나기 때문에 캐릭터 설정과 장면 원고가 외부로 나가지 않습니다. 가중치와 API는 공개하지 않습니다.
두 모델이 만나는 곳 — 캐릭터 바이블
두 모델은 서로 다른 일을 하지만 같은 원본을 봅니다. 캐릭터 바이블입니다. Nexus Talk에서는 바이블이 시스템 프롬프트가 되어 말투와 성격을 정하고, 모델은 대화의 리듬만 책임집니다. LiloImage에서는 바이블의 외형 문장이 머리색과 복장의 정답이 되고, 모델은 구도와 그림만 책임집니다. 모델이 결정할 것과 설정이 결정할 것을 나눈 것 — 두 모델에 공통된 설계 원칙입니다.
- Nexus Talk — 공개 오픈 웨이트 LLM · 27B · bfloat16 · Apache-2.0 · vLLM 서빙 · 19세 이상
- LiloImage — 사내 전용 이미지 모델 · 1664×2216 · 장면당 약 40초 · 외부 API 없음 · 비공개
범용 모델은 평균을 잘합니다. 캐릭터는 평균이 아니라 한결같음으로 기억됩니다.
— ONE AI Labs
Nexus Talk는 Hugging Face에서 바로 받아 vLLM으로 띄울 수 있습니다. 시스템 프롬프트에 캐릭터 하나를 적고, 몇 턴만 대화해 보세요. 답이 아니라 대화가 돌아오는 것을 확인할 수 있습니다.