Model
말하는 모델과 그리는 모델 — Nexus Talk와 LiloImage
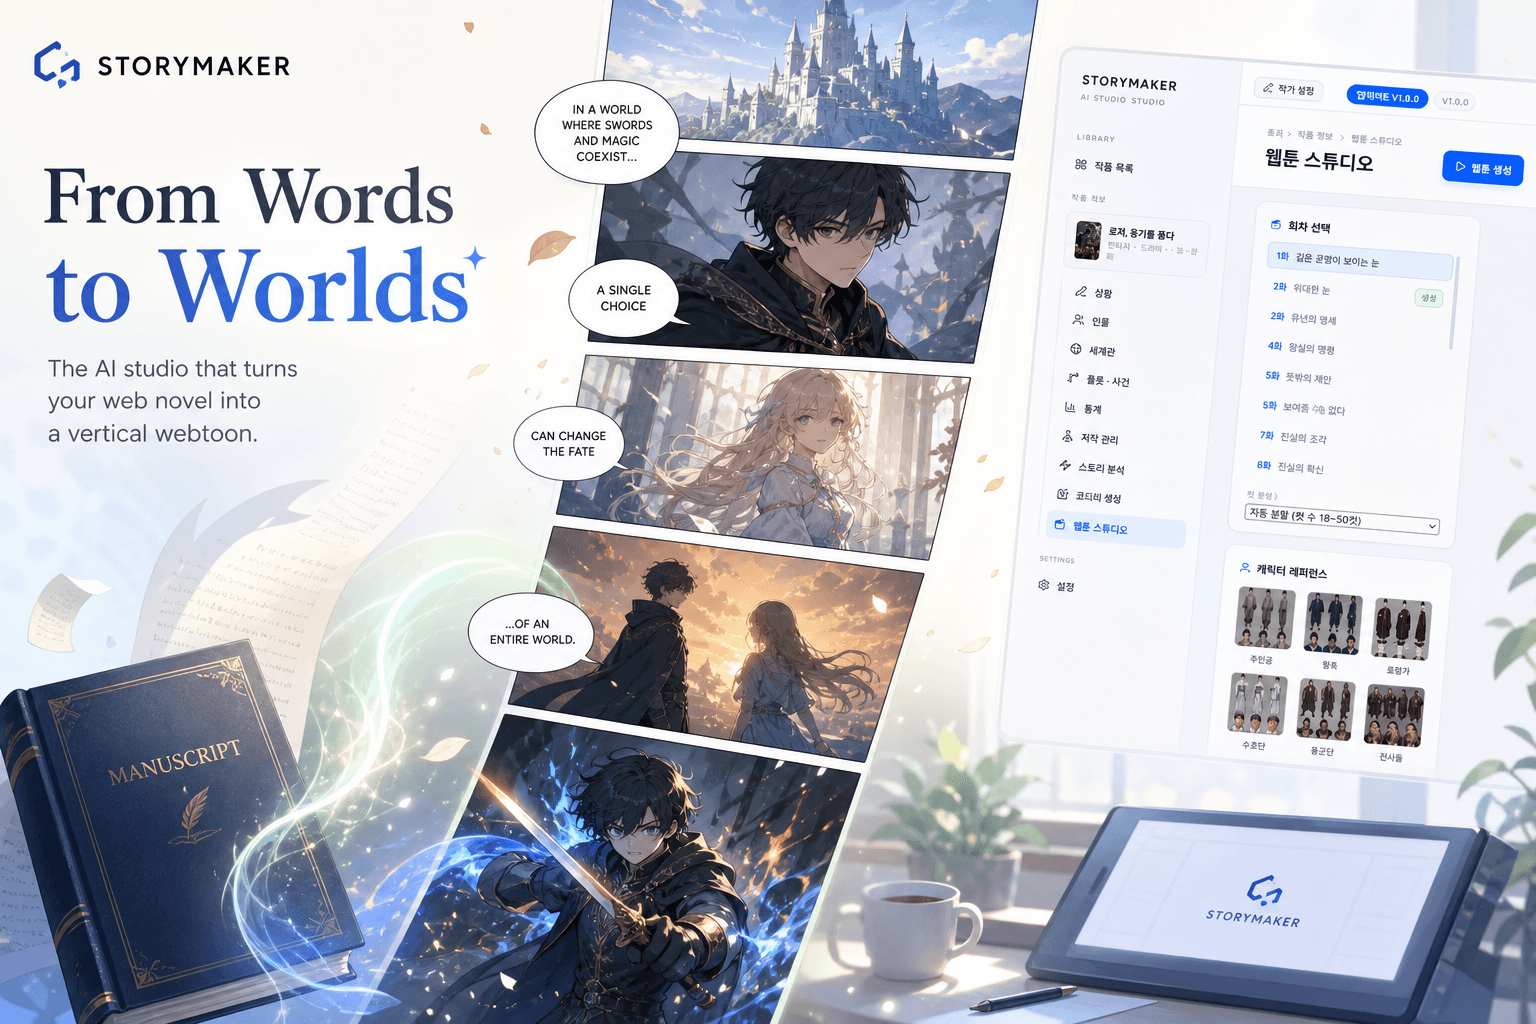
캐릭터는 말을 건네고, 눈에 보여야 합니다. 턴 단위 대화 리듬을 학습한 27B LLM Nexus Talk, 장면이 바뀌어도 같은 얼굴을 그리는 애니메이션 이미지 모델 LiloImage. 응답은 사람의 대화 턴 길이로 줄이되 말투는 그대로 지키고, 외부 API 없이 GPU 한 장에서 장면당 약 40초 만에 같은 캐릭터를 다시 그려 냅니다. 범용 모델이 평균을 좇는 자리에서, 두 모델은 한 캐릭터의 일관성을 끝까지 지킵니다.
#LLM#Image Model#Nexus Talk
O
ONE AI Labs26. 09. 30. · 11분 읽기