
한국어 캐릭터 대화에 맞춘 27B 오픈 웨이트 LLM
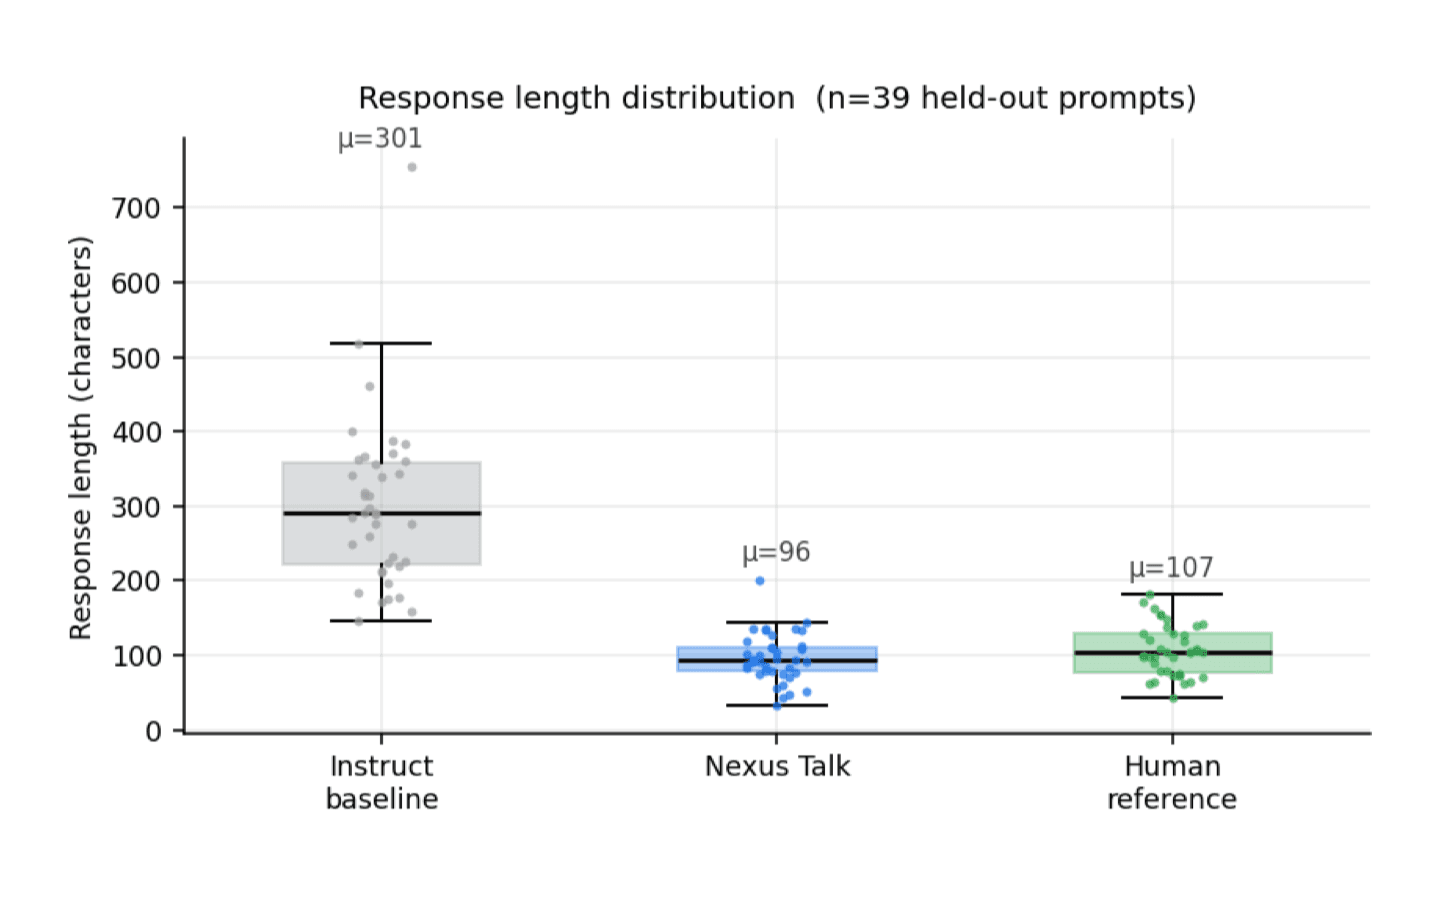
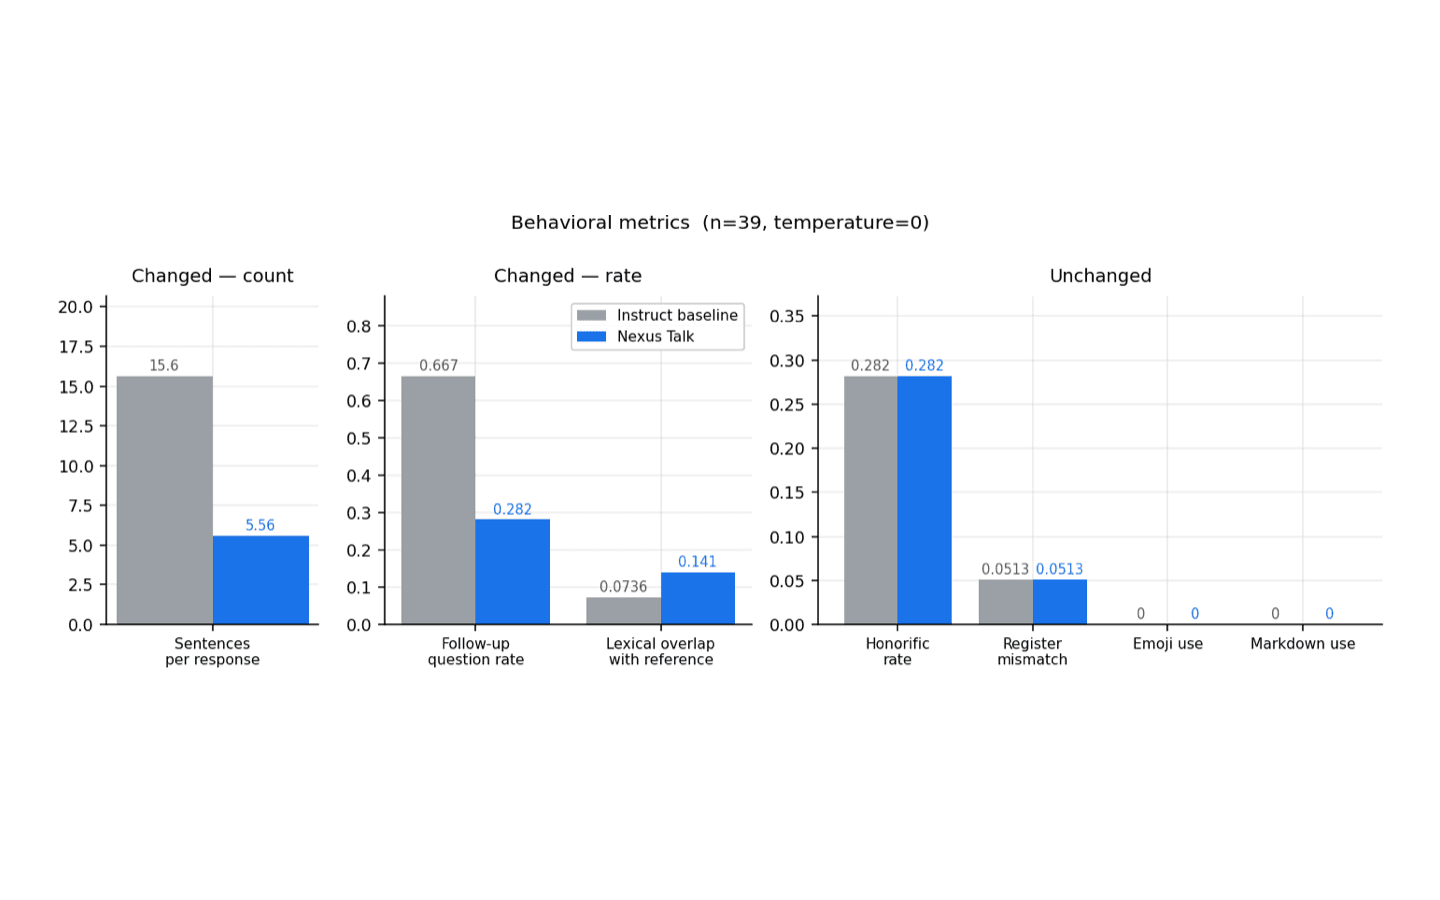
Instruct 모델은 '답'하도록 만들어집니다. Nexus Talk는 '대화'하도록 만들었습니다. 한국어 멀티턴 캐릭터 대화로 턴 단위 행동 — 얼마나 말하고, 언제 멈추고, 언제 발언권을 넘기는지 — 을 학습한 27B 모델입니다. 같은 급의 Instruct 모델과 비교해 평균 응답 길이는 301자에서 96자로 줄어 사람이 쓴 턴(107자) 범위 안에 들어왔고, 되묻는 질문 비율은 0.667에서 0.282로 낮아졌습니다. 존댓말 비율·서식 같은 스타일 지표는 그대로여서 캐릭터의 말투는 시스템 프롬프트가 결정합니다. LoRA를 병합한 bfloat16 가중치를 Apache-2.0으로 Hugging Face에 공개했고, vLLM으로 바로 서빙할 수 있습니다.
주요 기능
- 턴 단위 대화 적응 — 한 가지를 말하고 멈추며, 필요할 때만 되묻습니다
- 평균 응답 길이 −68% (301 → 96자), 사람 턴 대비 길이 오차 −80%
- 캐릭터 흔들기 입력 10건 — 캐릭터 이탈 0 · 영어 전환 0 · 시스템 프롬프트 유출 0
- 하이브리드 어텐션(linear + full) 디코더 · 권장 컨텍스트 8,192 토큰
- vLLM OpenAI 호환 API로 즉시 서빙 — 요청마다 thinking 비활성화 필수
- 19세 이상 전용 · 사실 질의응답 · 요약 · 코드 생성은 사용 범위 밖
이 레퍼런스가 증명하는 기술
39개 중 39개, 사람에 더 가깝다
학습에 쓰지 않은 프롬프트 39개 모두에서 Instruct 모델보다 사람이 쓴 턴 길이에 더 가깝게 답했습니다. 응답 길이도 32~201자로, 사람 턴의 범위 안에 모입니다.
행동은 바꾸고, 목소리는 그대로
턴 길이 · 문장 수 · 되묻기 비율은 바뀌었지만 존댓말 비율(0.2821), 말투 불일치, 이모지 · 마크다운 사용은 소수점 넷째 자리까지 같습니다. 말투와 톤은 시스템 프롬프트의 몫입니다.
끝까지 캐릭터로 남는다
AI냐고 묻고, 시스템 프롬프트를 요구하고, 캐릭터 밖의 답을 강요하는 입력 10건에서 이탈 · 영어 전환 · 프롬프트 유출이 한 번도 없었습니다.
한국어 출력 정비 (v0.2)
학습 데이터의 영문 캐릭터 카드를 한국어로 옮기고 한자 · 엠대시를 걷어냈습니다. 28턴 장기 대화 테스트에서 중복 문장부호(.— · .…)가 0건으로 사라졌습니다.